
Neste artigo
- Como o LiteRT-LM acelera a inferência local com o Gemma 4
- A mágica da localidade de memória
- Eficiência de memória e a redução drástica do footprint
- Gestão de sessões e a experiência do usuário
- Capacidades agenticas e o Thinking Mode
- Expansão de ecossistema: Swift e JavaScript
- O impacto para o mercado de desenvolvimento no Brasil
- O futuro da IA local e os próximos passos
- O que é o LiteRT-LM?
- Qual a diferença entre LiteRT e LiteRT-LM?
- Como o Multi-Token Prediction (MTP) funciona na prática?
- O LiteRT-LM funciona em qualquer smartphone?
A execução de modelos de linguagem extensos (LLMs) diretamente no dispositivo do usuário sempre foi um desafio de equilíbrio entre performance e consumo de bateria. O Google acaba de tentar resolver essa equação com o lançamento do LiteRT-LM, um framework que otimiza a inferência local do Gemma 4, prometendo velocidades até 2,2 vezes superiores graças a uma técnica chamada Multi-Token Prediction (MTP).
O que você precisa saber:
O LiteRT-LM é uma camada de orquestração sobre o LiteRT (antigo TensorFlow Lite) que permite rodar o Gemma 4 em Android, iOS e Web com maior eficiência, reduzindo a latência de resposta e o uso de memória RAM.
Como o LiteRT-LM acelera a inferência local com o Gemma 4
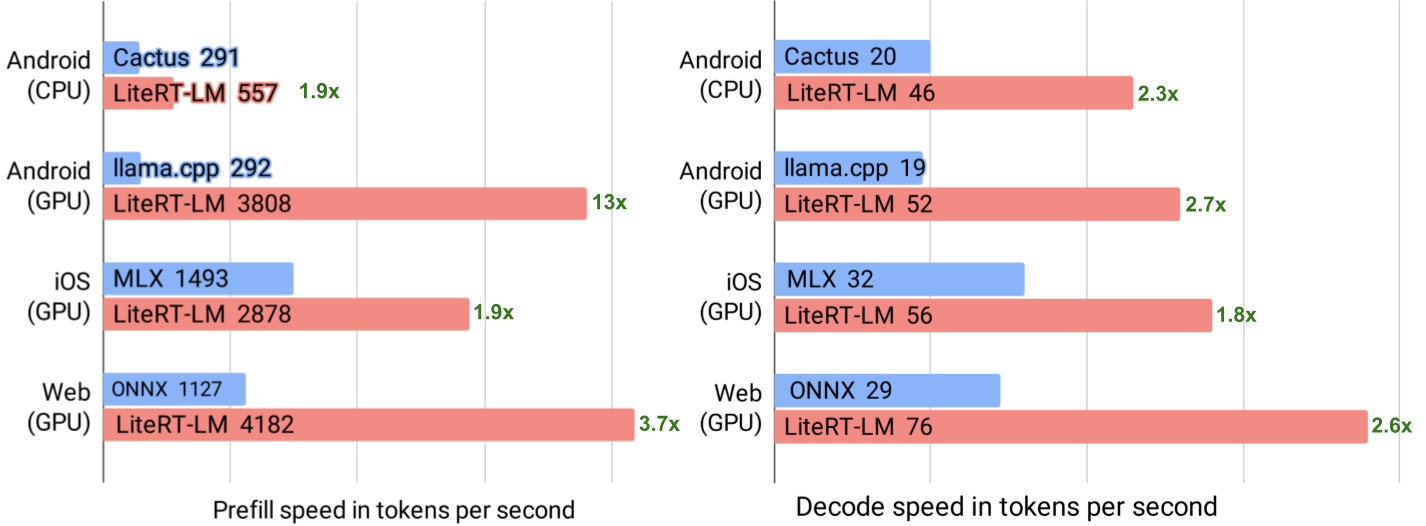
Para desenvolvedores que trabalham com IA on-device, o maior gargalo não é apenas o poder de processamento, mas a movimentação de dados entre a memória (VRAM) e as unidades de computação. O LiteRT-LM ataca esse problema implementando o Multi-Token Prediction (MTP) via decodificação especulativa. Em vez de prever um token por vez, o sistema gera múltiplos tokens em paralelo, que são verificados em um único ciclo de processamento.
Essa abordagem é especialmente eficaz porque muitas previsões de linguagem são óbvias e não exigem a carga computacional total do modelo principal. Ao delegar essas partes simples para um "drafter" (rascunhador) leve, o sistema economiza ciclos de CPU e GPU, resultando em respostas que aparecem quase instantaneamente para o usuário final.
Resposta rápida: O LiteRT-LM aumenta a velocidade de decodificação em 1,6x para o modelo Gemma 4 E2B e em até 2,2x para o Gemma 4 E4B, superando frameworks como llama.cpp e ONNX em performance de prefill e decode.
A mágica da localidade de memória
Um dos diferenciais técnicos do framework é a imposição da localidade de memória. O LiteRT-LM executa tanto o modelo principal quanto o rascunhador MTP no mesmo hardware IP (como a GPU). Isso elimina a penalidade de latência causada pela sincronização entre diferentes processadores, algo que costuma drenar a bateria e causar engasgos em apps mobile.
Para o desenvolvedor brasileiro que cria apps para mercados com hardware diversificado, essa otimização é crucial. Ela permite que a IA funcione de forma fluida mesmo em dispositivos intermediários, expandindo o alcance de funcionalidades de IA generativa sem exigir que o usuário possua o smartphone mais caro do mercado.
Eficiência de memória e a redução drástica do footprint
Rodar modelos de bilhões de parâmetros em dispositivos móveis geralmente requer compressões agressivas que podem degradar a qualidade da resposta. O Google resolveu isso no LiteRT-LM minimizando o footprint de memória ao manter embeddings de camadas fora da memória principal e carregando codificadores de imagem e áudio apenas sob demanda.
O impacto prático é impressionante: o modelo Gemma 4 E2B, que originalmente ocupa cerca de 2,58 GB, consegue operar consumindo apenas 607 MB em CPUs mobile da Apple. Isso abre espaço para que o sistema operacional não encerre o app por falta de memória, proporcionando uma experiência de usuário muito mais estável.
Recurso | Impacto Técnico | Benefício para o Dev/Usuário |
|---|---|---|
Multi-Token Prediction | Decodificação especulativa | Respostas mais rápidas (até 2.2x) |
Dynamic Loading | Carregamento sob demanda | Menor consumo de RAM (ex: 2.58GB → 607MB) |
Session Management | Salvamento de estado KV cache | Continuidade de chats sem recomputação |
Gestão de sessões e a experiência do usuário
Outro ponto fundamental é a gestão de sessões tratada como prioridade. O framework consegue salvar e restaurar o estado do KV cache, o que significa que o modelo não precisa "reler" toda a conversa a cada nova interação. Em termos de desenvolvimento, isso reduz o custo computacional de interações longas, tornando o chat mais ágil e economizando bateria.
Para quem desenvolve agentes de IA, essa capacidade de manter o contexto sem reprocessamento constante é a diferença entre um app que parece "travado" e um que flui naturalmente, simulando uma conversa humana em tempo real.
Capacidades agenticas e o Thinking Mode
O LiteRT-LM não foca apenas em velocidade, mas também em inteligência estruturada. Ele traz suporte nativo ao "Thinking Mode" do Gemma 4, permitindo que o modelo realize raciocínios complexos antes de entregar a resposta final. Isso é essencial para a criação de agentes que precisam planejar passos antes de executar uma função.
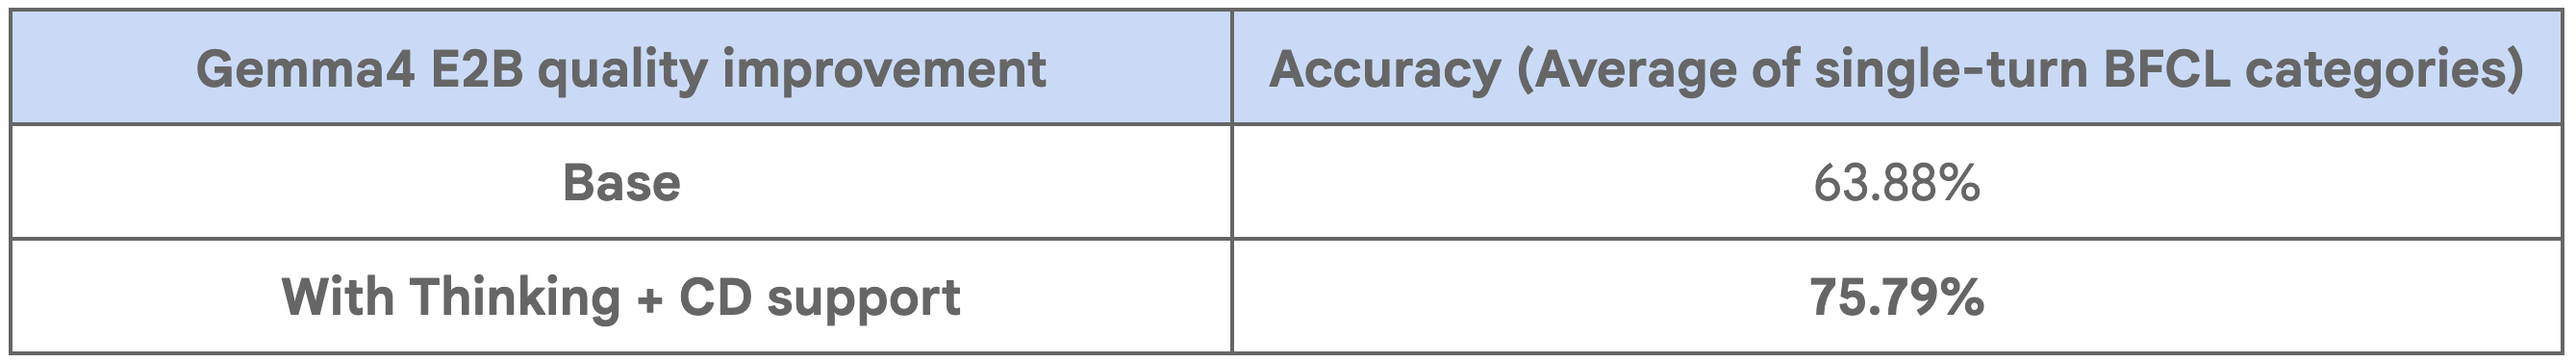
Além disso, o suporte a constrained decoding garante que as saídas sejam estruturadas (como JSONs perfeitos), facilitando a integração com APIs e chamadas de função (function-calling). O modelo pode pausar a execução, solicitar a chamada de uma ferramenta externa e retomar o processamento assim que receber o dado, tudo isso localmente.
A capacidade de executar o raciocínio (Thinking Mode) e a chamada de funções localmente transforma o smartphone em um agente autônomo, reduzindo a dependência de chamadas de API caras e lentas para a nuvem.
Expansão de ecossistema: Swift e JavaScript
Anteriormente limitado a Kotlin e C++, o framework agora expande seu suporte para APIs de Swift e JavaScript. Isso democratiza o acesso para desenvolvedores iOS e web, permitindo a implementação de LLMs locais via WebAssembly ou nativamente no ecossistema Apple com muito menos fricção.
Isso significa que a barreira de entrada para criar apps com IA local caiu significativamente. Agora, um desenvolvedor frontend pode experimentar a implementação de modelos Gemma 4 usando linguagens que já domina, acelerando o ciclo de prototipação e entrega.
O impacto para o mercado de desenvolvimento no Brasil
No cenário brasileiro, onde a conectividade instável ainda é um problema em diversas regiões, a IA on-device é uma vantagem competitiva imensa. Apps que funcionam offline ou que processam dados sensíveis localmente ganham a confiança do usuário e evitam a latência de servidores localizados nos EUA ou Europa.
Para o desenvolvedor que busca evoluir na carreira, dominar frameworks de inferência local como o LiteRT-LM coloca o profissional em um patamar de "AI Engineer」, capaz de otimizar custos de infraestrutura para empresas, já que o processamento é movido do servidor para o dispositivo do cliente.
A recomendação para quem quer começar é explorar o repositório no GitHub do projeto, utilizar a CLI para testes em desktop e, posteriormente, implementar a versão mobile para validar a performance em hardware real. A transição da teoria para a prática exige atenção ao gerenciamento de memória, mas as ferramentas fornecidas pelo Google tornam esse processo mais intuitivo.
O futuro da IA local e os próximos passos
A tendência é que a dependência de modelos gigantescos na nuvem diminua em favor de modelos menores, porém altamente otimizados e especializados. O LiteRT-LM mostra que a eficiência não vem apenas de modelos menores, mas de como o runtime gerencia o hardware.
Para os devs brasileiros, o caminho agora é integrar essas capacidades em portfolios e projetos reais. Criar um assistente que funcione offline, que respeite a privacidade do usuário e que responda instantaneamente é o tipo de projeto que chama a atenção de recrutadores de big techs e startups de inovação.
Você já experimentou rodar algum modelo localmente ou ainda depende totalmente de APIs de nuvem? A mudança para o processamento on-device pode ser o diferencial técnico que seu projeto precisa para escalar com custo zero de servidor.
Perguntas frequentes
O que é o LiteRT-LM?
É uma camada de orquestração especializada para LLMs, construída sobre o LiteRT (antigo TensorFlow Lite), focada em rodar modelos Gemma 4 localmente em Android, iOS e Web com máxima performance e menor consumo de memória.
Qual a diferença entre LiteRT e LiteRT-LM?
Enquanto o LiteRT é o runtime geral para diversos modelos de ML, o LiteRT-LM é otimizado especificamente para Large Language Models, incluindo suporte a Multi-Token Prediction e gestão avançada de KV cache para conversas.
Como o Multi-Token Prediction (MTP) funciona na prática?
O MTP usa decodificação especulativa para prever vários tokens simultaneamente. Um modelo leve sugere a sequência e o modelo principal a valida em um único passo, reduzindo a movimentação de dados e acelerando a resposta em até 2.2x.
O LiteRT-LM funciona em qualquer smartphone?
Ele é projetado para ser eficiente em hardware fragmentado, mas a performance máxima depende da GPU e da quantidade de RAM do aparelho. O framework utiliza quantização e kernels otimizados para garantir que funcione mesmo em dispositivos intermediários.


